移动人工智能创作者,用于设备上的图像和短视频生成
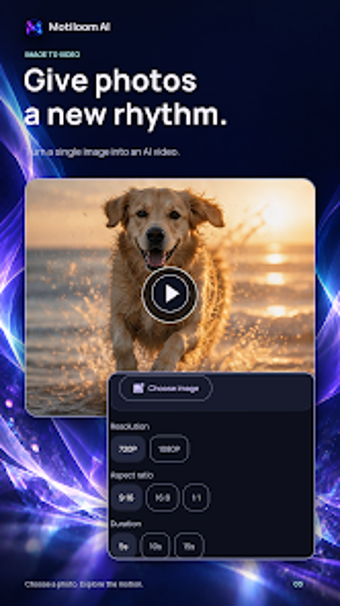
从文本提示或照片生成图像和短视频,直接在一个工作流程中从静态图像转向动态。Motiloom AI,由TINESHIA IEESHA JONES开发,将四种创作模式(文本到图像、图像到图像、文本到视频、图像到视频)和策划模板打包成一个单一的Android工具。该应用程序通过避免广告和追踪来强调隐私,目标是希望快速、以移动为主的AI内容创作的成人创作者和社交媒体作者,而无需 juggling 多个工具。
应用程序实际产生的内容以及如何控制它
Motiloom AI 提供了四条具体的生产路径:将文本转换为图像、改变现有照片、根据提示渲染短片,或将选定的图像动画化为视频。精心策划的模板加快了项目启动,而所述的工作流程将项目从提示移动到同一应用程序内的保存文件。Android 照片选择器用于图像选择,因此您可以选择媒体而无需授予广泛的图库访问权限。
它在设备上的行为以及何时运行工作
开发者表示,渲染在后台进行,而应用程序处理复杂步骤,这使得界面专注于创意选择。该版本被设计为私密,未包含广告或行为分析。由于它针对 Android 设备并依赖系统媒体 API,创作者应预期该应用程序遵循正常的移动资源模式,而不是桌面级的批量吞吐量。
谁可以使用它以及需要多少技能
Motiloom AI 旨在简化创意任务:模板和单按钮模式让非技术创作者无需手动设置管道即可生成输出,而图像到图像和图像到视频则为希望控制的用户提供了更有针对性的工作流程。该应用程序面向 18 岁及以上的成年人设计,并且设计消除了在移动设备上工作时需要在单独的图像和视频工具之间切换的需求。
适合移动创作者,但受限于安卓独占
Motiloom AI 适合希望从提示或照片到短视频或图像的私人单一应用路线的安卓创作者。它将创意步骤集中到一个移动流程中,避免跟踪,这对注重隐私的用户有利。主要的限制是平台范围:它仅在安卓设备上运行,这限制了需要跨平台连续性或基于桌面的工作流程的创作者的使用。